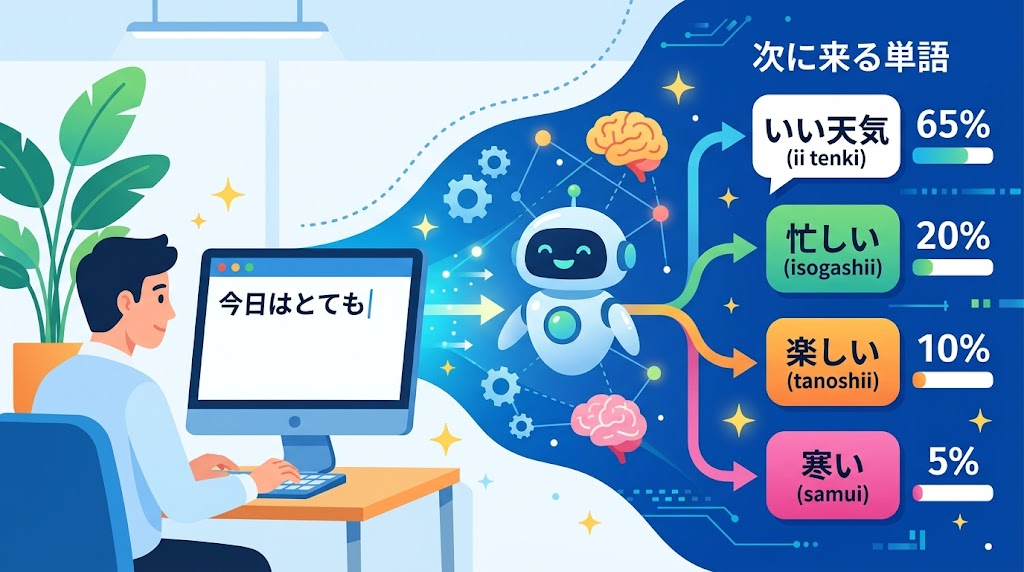
生成AIは、どうやって文章を作っているのか――そんな疑問に、公式の教材で確認できた内容で答えます。
この記事でわかること
- 次のトークンの予測
- Transformerとは
- 学習の基本
結論から言うと、大規模言語モデル(LLM)の基本は、次に来るトークンの確率を予測して、それを繰り返して、文章にすることです。
1. 次のトークンの予測
Googleの公式の教材は、LLMを「高度なオートコンプリート」と説明しています。プロンプトを文脈として、次に来るトークンの確率の分布を生成し、それを繰り返して、文章にします。
2. Transformer
2017年のGoogleの論文「Attention Is All You Need」で提案された、注意機構(attention)のみに基づく、アーキテクチャです。Googleの教材では、自己注意(self-attention)が、「各トークンが、他のトークンの解釈に、どれだけ影響するか」を捉えると説明されています。
3. 事前学習
大量のテキストでの教師なし学習(トークンの予測)が基本です。オプションとして、指示への追従性を高める、instruction tuningがあります。
4. 確認できていないこと
- ファインチューニングの、公式の詳しい定義
- RLHFの、公式のページ
5. 関連する記事
トークンについては、別記事「生成AIの『トークン』とは」をご覧ください。
まとめ
- 次のトークンの確率を予測して、文章を作る
- Transformerの注意機構が、基本
- RLHFの詳細は、確認できていない
よくある質問(FAQ)
Q. AIは意味を理解していますか?
確認できていません。
Q. 同じ質問で答えが変わるのはなぜですか?
別記事「生成AIのtemperature設定」をご覧ください。
Q. ディープラーニングとの関係は?
別記事「生成AIとディープラーニングの違い」をご覧ください。
